项目地址:https://github.com/Niko1221/Strata
模型地址:https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF/tree/main/IQ3_XXS
windows直接到github中直接下载安装就能使用,Linux需要自己编译,下方是我装的ubuntu系统来使用的。
先说结论
9月1日我发过一篇《5070ti16g单卡跑qwen 3.8 flash next iq4x gguf Hermes调用 18tokens/s》,当时用 llama.cpp + IQ4_XS 量化,单卡输出速度最高 18-19 t/s。
这次更新:同一台机器、同一张 5070 Ti 16G,换用 Strata 引擎 + ISTA-DASLab 的 GSQ-RCO IQ3_XXS 量化,输出速度最高到 90 t/s,Hermes 日常调用稳定在 60 t/s 左右——基本追平云端模型的手感,长任务不再需要盯着进度条等。
速度提升 3-5 倍,靠的不是更强的显卡,而是两件事:换引擎(Strata)+ 换量化方案(GSQ-RCO)。
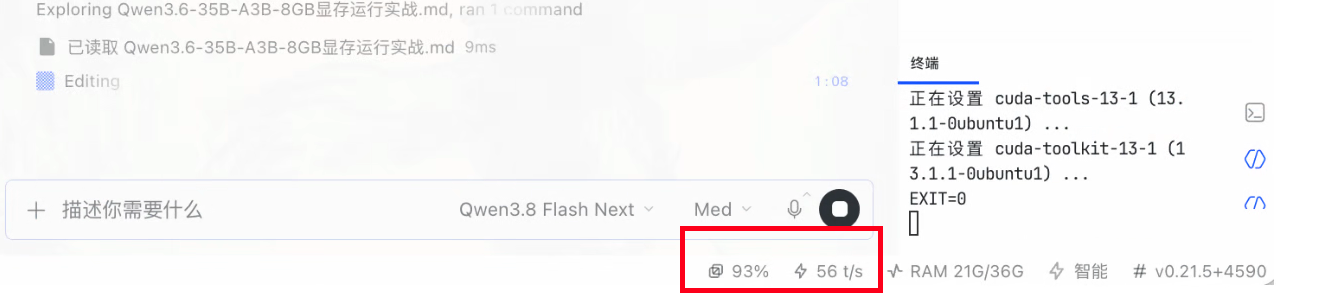
Hermes调用 基本和云端模型差不多,非常流畅,加载也不想之前等半天才能运行,这个方案非常靠谱。
我的电脑配置
- i5 12代处理器
- 64G DDR4 内存
- RTX 5070 Ti 16G(本次单卡运行,3070 8G 不参与)
- 2T NVMe 高速硬盘
- 系统:Ubuntu 26.04(上次是 Win11,这次换 Linux,Windows 下同样可以跑)
模型和引擎
模型(IQ3_XXS 量化版,两个分卷共 75.8GB):
- https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF/tree/main
- 注意:这是 ISTA-DASLab 对 Qwen3.8-Flash-Next 基座做的 GSQ-RCO 重新量化,不是 Qwen 官方原始 GGUF。GSQ-RCO 的卖点是用更小的体积保住精度——官方数据 IQ3_S 在公开基准上能对上完整 BF16 模型,IQ3_XXS 比它小、比它快
- 同架构还有 UkisAI 的 Swift 1.5 微调版(thinking 短 63%、回答快约 1.8 倍,适合追求响应速度的场景):https://huggingface.co/ukisai/Swift-1.5-Qwen3.8-Flash-Next-GSQ-RCO-GGUF
引擎:
- Strata(https://github.com/Niko1221/Strata),本次用 v0.1.28,Linux 源码编译
- 它不是 llama.cpp 的调参版,是为这类超大 MoE(125B、512 experts)专门设计的推理引擎
为什么从 18t/s 变成 60-90t/s
上次 llama.cpp 的玩法是 attention 上 GPU、expert 走 CPU(--n-cpu-moe / auto-fit),每个 token 都要大量 CPU 读 expert 权重,16G 显存卡在这类 MoE 上天花板就是 20 t/s 附近。
Strata 的做法完全不同,实测下来三个关键点:
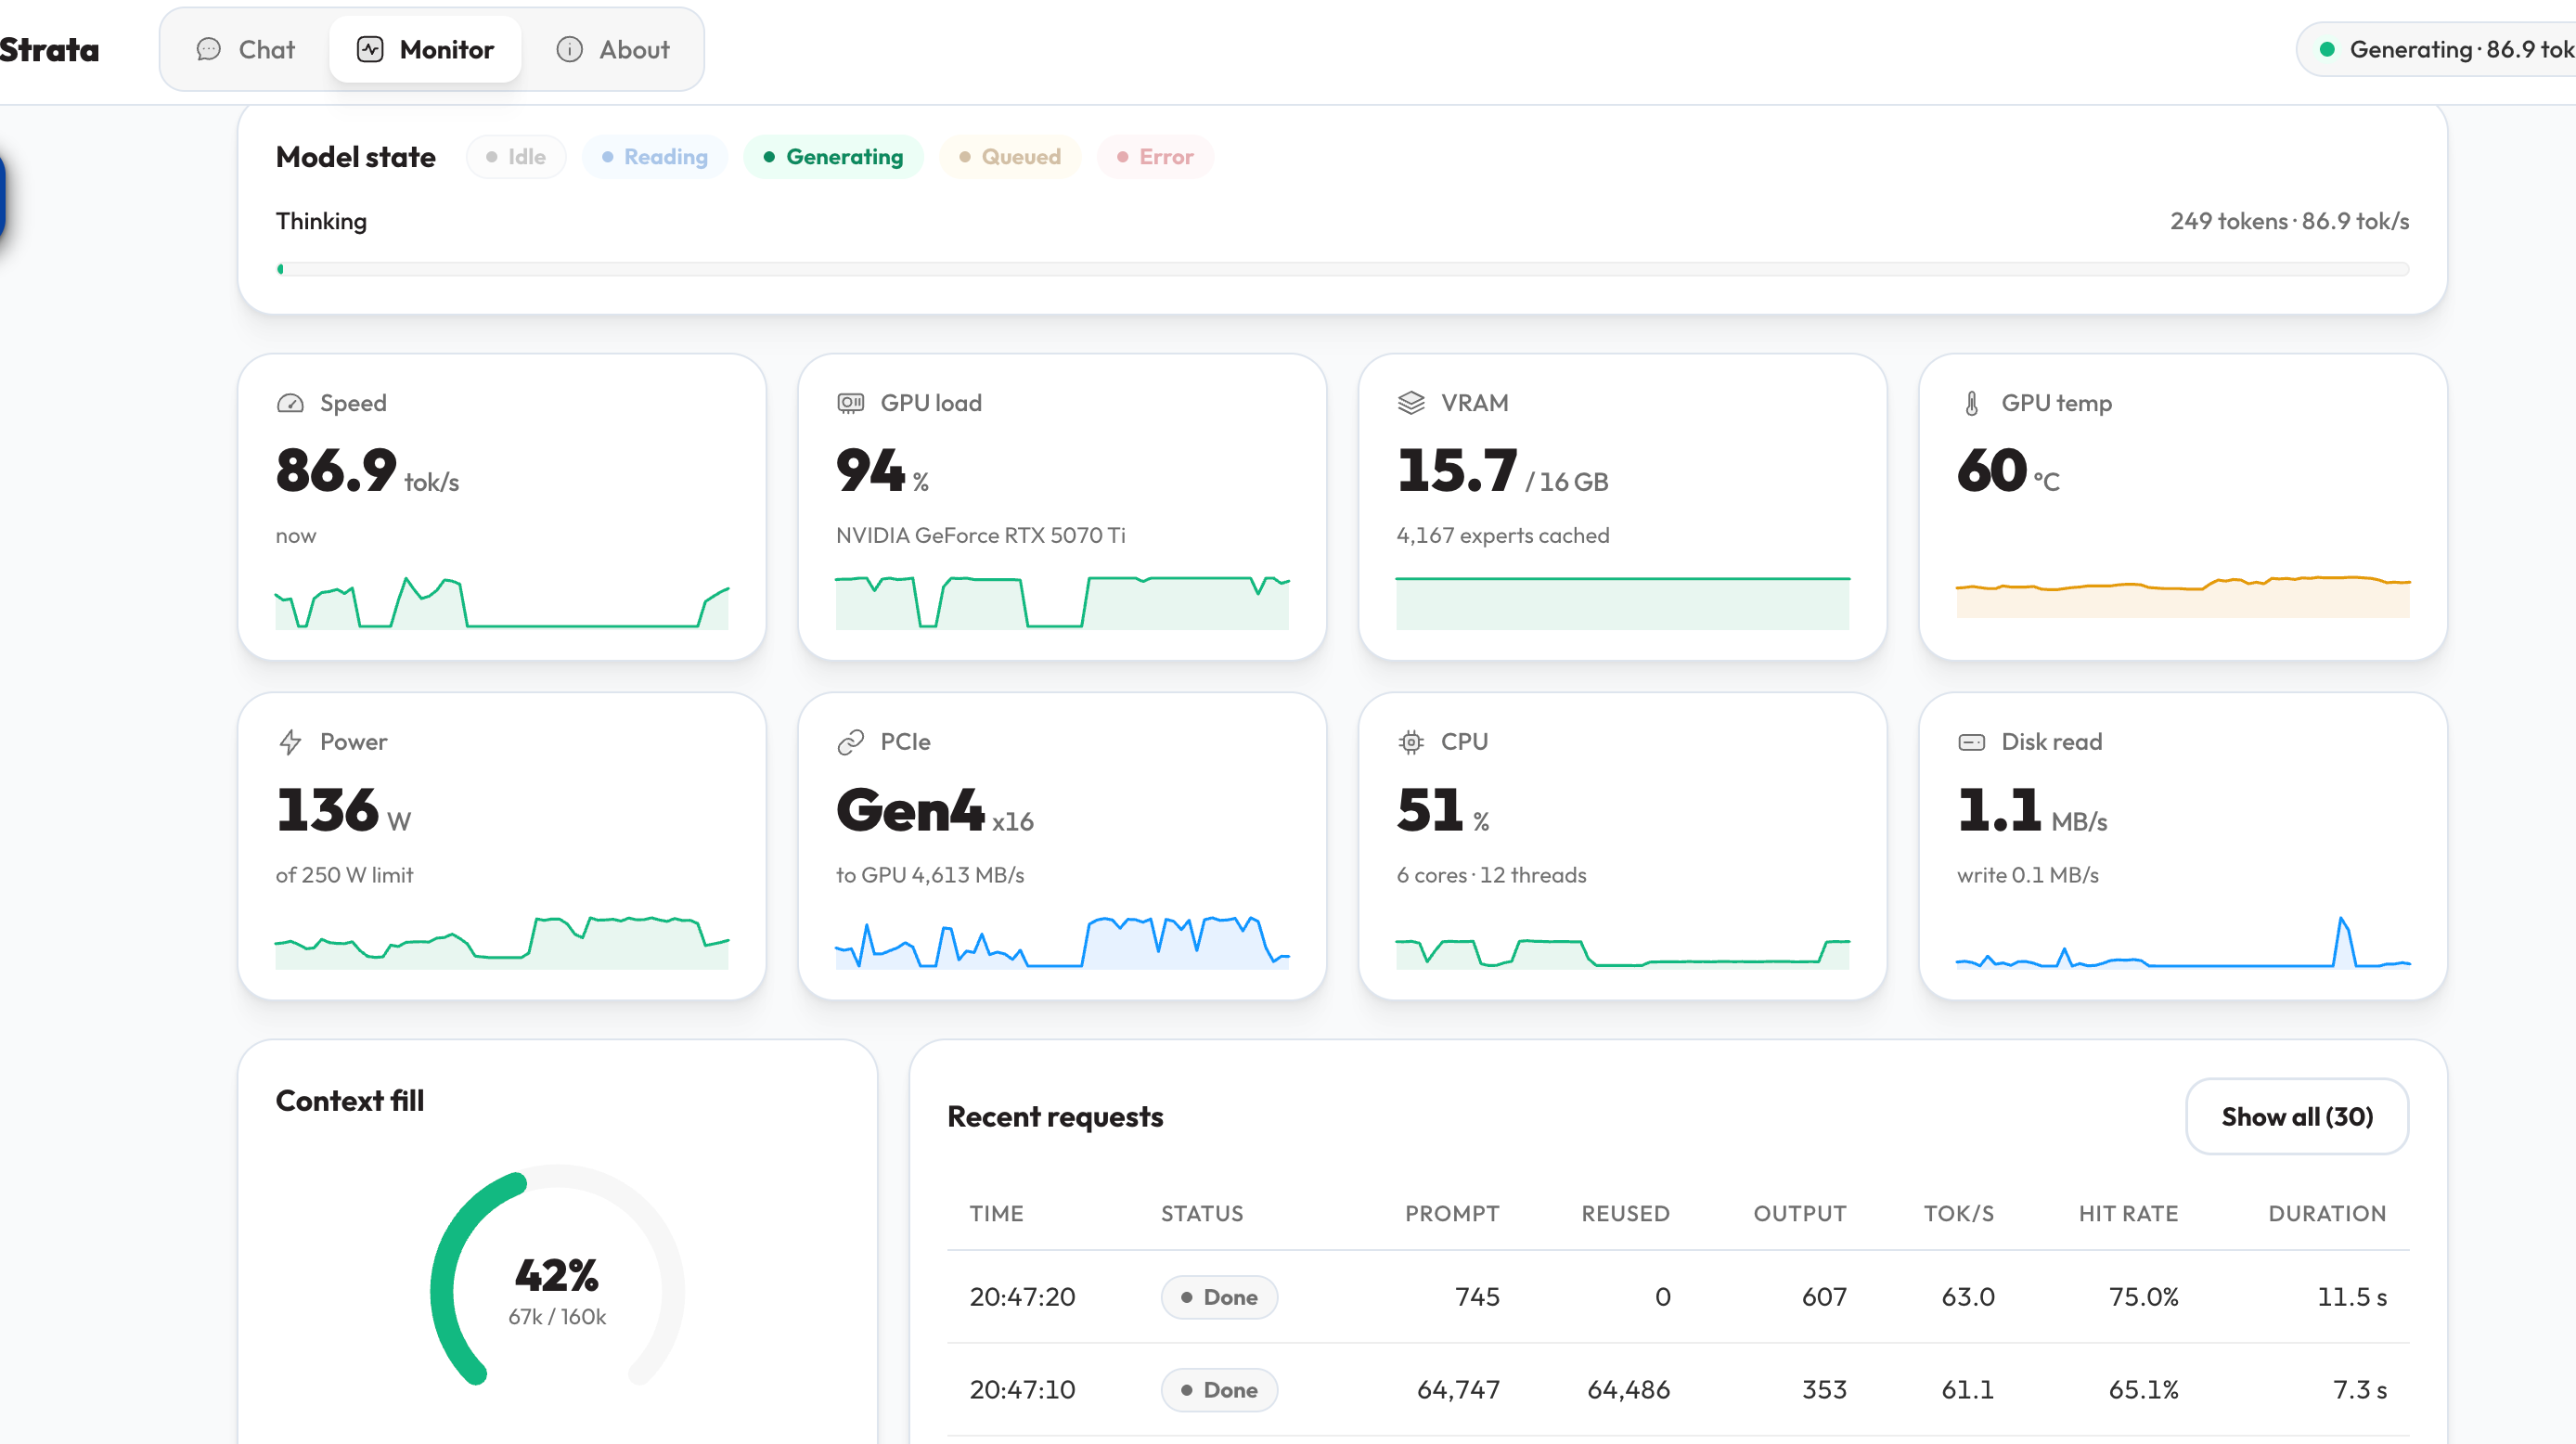
- expert 全放内存 + GPU expert cache:40GB expert 一次性装进内存(加载约 52 秒),GPU 显存里只放一个”热点 expert 缓存”——实测缓存了 4167 个 expert、占 6.78GB 显存,运行中命中率 67-71%。大部分 token 的 expert 计算直接在显存里完成,不再反复走 CPU。
- MTP 投机解码:Strata 单独提取 draft 层做 speculative decoding(
--spec 4),配合 0.1.27 之后把 draft 词表扩到全部中文字符,中文输出再快 15-38%。 - IQ pack 预处理:首次启动会把 GGUF 重排成 pack 格式(约 30-60 分钟,期间机器会卡),之后每次秒起。重排后的 expert 布局对 CPU/GPU 分工做了优化。
实测速度(160160 上下文)
| 场景 | 速度 |
|---|---|
| 短输出 / 缓存热了之后 | 最高 90 t/s |
| Hermes agent 日常调用(工具调用、长任务) | 稳定 60 t/s 上下 |
| thinking 阶段 | 52-66 t/s |
| prompt 读取(prefill) | 32K token 约 4 秒 |
对比上次 llama.cpp IQ4_XS 方案的 18-19 t/s:同样的硬件,输出速度 3-5 倍,上下文还从 128K 提到了 160K。
和上次一样,预热很重要:expert cache 需要一段时间填满,刚启动的头几个请求偏慢,跑热之后速度非常稳定。Hermes 长时间挂机会把缓存命中率越跑越高(我这边从 67% 爬到 71%+)。
部署要点(Linux)
# 1. 下载源码(release 只有 Windows 预编译包,Linux 走源码)
wget https://github.com/Niko1221/Strata/archive/refs/tags/v0.1.28.tar.gz

# 2. 一键 setup + 起服务(首次会编译引擎 + 构建 pack,共 40-80 分钟)
cd Strata-main
.venv/bin/python setup.py --family qwen --model IQ3_XXS --context 160160 \
  --vision none --gguf-dir /path/to/Qwen3.8-Flash-Next-GSQ-RCO-GGUF-iq3xxs \
  --port 8080 --host 0.0.0.0 --api-key "你的key" --yes
起好后就是标准 OpenAI 接口,Hermes / OpenWebUI 直接对接:
curl -H "Authorization: Bearer 你的key" \
  http://192.168.123.133:8080/v1/chat/completions \
  -d '{"model":"qwen3.8-flash-next-iq3_xxs","messages":[{"role":"user","content":"你好"}]}'
几个要注意的坑
- 内存要求硬:64GB 是及格线(expert 占 40GB),机器上别同时跑大东西。
- 160K 上下文下显存很紧:实测 15.6/16.3GB(96%)。如果碰到 OOM 或卡顿,把上下文降到 131072,显存压力会小很多。
- Ubuntu 26.04 + CUDA 13.1 编译必挂(glibc 2.43 头文件冲突),装
cuda-toolkit-13-3解决;nvcc 的 host 编译器要强制用 g++-13。 - setup.py 有个 128K 封顶逻辑会把 160160 压回 131072,改一行
ctx > 131072→ctx > 200000即可放行。 - 别升 0.1.27:它的中文 draft 词表更新有显存 bug,16G 卡会卡死请求,直接上 0.1.28。
- 对外监听一定带 API key:
--host 0.0.0.0时 setup 的--api-key会保护所有端点,无 key 直接 401。
总结
- 上次:llama.cpp + IQ4_XS,18-19 t/s,能用但慢
- 这次:Strata 0.1.28 + GSQ-RCO IQ3_XXS,最高 90 t/s,Hermes 调用 60 t/s,160K 上下文
- 16G 显存跑 125B MoE,瓶颈从来不在显存大小,在引擎怎么调度 expert。Strata 把”expert 放内存 + 显存缓存热点 expert + 投机解码”这条路走通了,本地模型和云端模型的速度差距第一次小到可以忽略。
- 代价是首次 pack 构建 30-60 分钟和 64GB 内存门槛,一次构建长期收益。