先给新朋友说一下环境
- Ubuntu 电脑(Qwen3.8-Flash-Next),25.6 万 token 上下文,推理引擎 Strata 0.1.44.1。
- 量化:从快到慢三档:IQ3_S(ista)→ IQ4_XS(huihui)→ Q4_K_XL(huihui)。
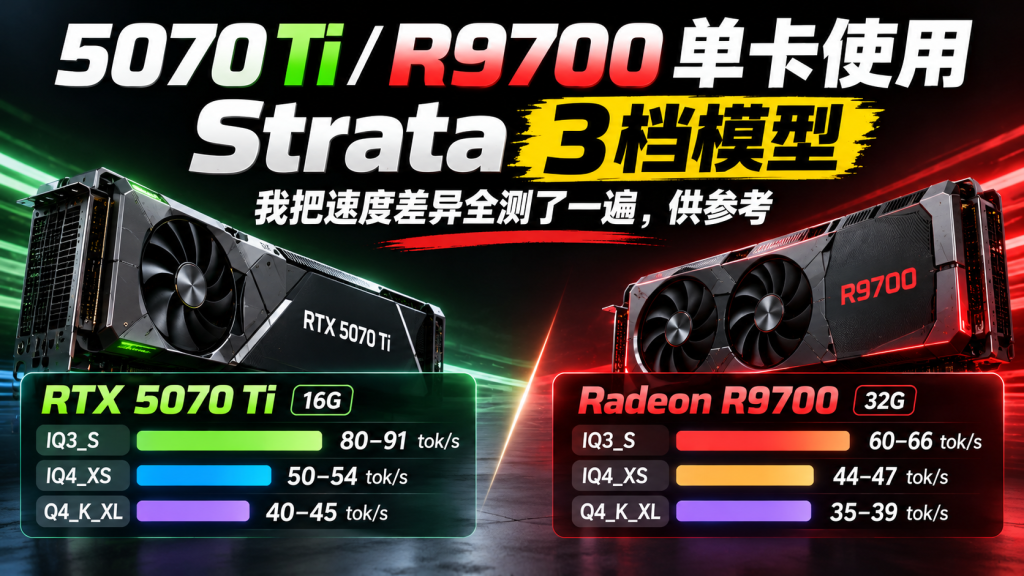
- 机器:i7-14700 + 128G 内存(ddr4)+ RTX 5070 Ti(16G 显存,功耗限制250w)+ Radeon R9700(32G 显存,功耗限制210w)——两张卡单卡轮流上,6 种组合全部实测。
实测总表(输出速度 = 每秒生成 token 数,越高越好)
| 组合 | 输出速度 | 预填充冷启动读长文(重启后首次全量读) | 状态 |
|---|---|---|---|
| 5070 Ti + IQ3_S | 80–91 | 复用缓存下约万级/秒 | 最快组合 |
| 5070 Ti + IQ4_XS | 50–54 | 2019/秒(7.3 万 token 实测) | 新入口,速度意外地稳(10-17 复查引擎日志众数 50–54,原记 54–55 偏高) |
| 5070 Ti + Q4_K_XL | 40–45 | 1473/秒(19 万 token 实测) | 显存只剩 415MiB,贴地飞行 |
| R9700 + IQ3_S | 60–66 | 1070→1320→1525/秒 | ✅ 三轮调优后 |
| R9700 + IQ4_XS | 44–47 | 838→1216→1468/秒 | ✅ 三轮调优后 |
| R9700 + Q4_K_XL | 35–39 | 400→676→~959/秒 | ✅ 三轮调优后 |
(负载是 10–18 万 token 的长对话 + agent 工具调用,不是玩具短问题。R9700 的冷启动数字走了三个阶段:8192 分块基线 → 16K 分块 → 32K 预填充块,下一节讲。)
真正涨速度的四个开关
1. WMMA 矩阵核心(读 prompt +23%,免费)
引擎横幅提示”设个环境变量,prompt 快约 30%”,R9700(HIP + KV int8)打开后冷读实测 1070→1320 字/秒。代价:输出末位舍入会变(非逐 bit 复现),日常无感。
2. 16K 分块读长文(IQ4_XS 实测 +43%,最大的一笔)
引擎默认把长文切成 8192 token 一块来读,每切一块,专家层权重就要在内存里多过一遍。改成 16384 一块=过的遍数减半:IQ4_XS 838→1216,Q4_K_XL 400→676。有前提:专家层必须整档驻留在内存(resident 模式),否则半截回硬盘捞数据,16K 反而踩坑。
3. 预填充块提到 32K(再 +20~35%)
继续加码 --prefill auto:32768:IQ4_XS 1216→1468、IQ3_S 17 万 token 大块冷读 1525、Q4_K_XL 676→~959(配合 worker 池 13→16)。同样有前提:这是 32G 显存卡上的数字——16G 的 5070 Ti 上大块会把显存缓存借爆,老老实实用 auto。
4. memlock 解锁(系统配置,一次性的)
memlock 是进程被允许”锁死(禁止换出)”的内存上限,出厂默认只有 8 MiB。当年把 28.8G 的路由表放内存(ram 模式)时,锁不够大就钉不进内存,内存一紧被回收就得边答边回盘捞,速度直接卡死在低位;后来实测认为路由表放固态硬盘直读(走页缓存、可回收、不占锁)更划算,现在已是默认。但别因此把 memlock 当摆设:引擎还会按档位把常驻专家区+KV 钉住(5070 Ti+IQ3_S 实测锁 26.8G),上限不够就钉失败退化(实测退化成 7–8 token/秒);而当前 IQ4_XS 配置实测只锁 0.5 MiB——留着它纯属免费保险。配置一次性的(limits.d 里 syxj 设 unlimited,今天进程仍带着生效)。一句话:跑大模型先把 ulimit -l 设成 unlimited。
测了但没涨的,也如实说
- 对话缓存(引擎官方推荐的多会话 KV 缓存):10 万+ token 超长对话下命中率实测为 0——单条对话快照 3+ GB,默认预算只装得下两条,纯摆设。
- 专家换入换出与计算重叠:引擎源码注释自己都写了”CPU 和拷贝抢内存带宽的机器可能倒亏”。实测:不亏不赚,保留。
- 4 根内存条:i7-14700 的内存控制器物理只有 2 通道,4 根只是容量大。这就是”每 token 要搬 1.5GB 专家权重”的 Q4_K_XL 在 A 卡上偏慢的根因——瓶颈不在显卡,在内存这条双车道马路。
看懂这张表的正确方式
每个量化档”每个字要从内存搬多少斤数据”是固定的:IQ3_S 约 1.0GB、IQ4_XS 约 1.16GB、Q4_K_XL 约 1.5GB。所以:
- 要速度:5070 Ti + IQ3_S,80–91 字/秒,肉眼跟不上手速,日常完全过剩。
- 甜点档:IQ4_XS——5070 Ti 上 50–54、R9700 上 44–47,质量接近 Q4_K_XL、速度接近 IQ3_S。R9700 只留一档的话,我留它。
- 要质量、不嫌慢:Q4_K_XL。N 卡 40–45,A 卡 35–39——N 卡输在显存小(16G),A 卡输在没有对应加速生态,各打五十大板。
- R9700 的独特价值:32G 显存让专家缓存命中率高、带视觉输入的 CPU 编码器、256K 长上下文稳
- 运行安静: 5070 Ti功耗限制250w,运行qwen3.8 flash next 量化IQ3_S IQ4_XS Q4_K_XL 非常安静,体感上远远好过涡轮卡r9700
最后
本地大模型没有”最佳配置”,只有”你这台机器的最佳配置”——内存几通道、系统锁了多大内存、长文分几 K 的块读,每一项都该实测;而且参数之间还互设前提(16K 分块要驻留模式、32K 大块要大显存),抄作业前先对设备。能实测就别猜。
下一篇做三档质量盲测:速度都摆这了,压得狠的那档到底掉多少智商,数据说话,不吹不黑。
测试环境:Strata v0.1.44.1,MTP 投机解码开启,parallel=1;数据为引擎日志原始值(prompt/done 行),日期 2026-10-15~16。
各组合生效参数(2026-10-17 用 133 实机的启停脚本、run-config、引擎进程命令行逐条核对,照抄可复现)
先列六档共同项:引擎 v0.1.44.1;上下文 262144(模型原生满值,无 YaRN);--kv int8 + --kv-resident 32768;--expert-cache auto;MTP 投机解码(--spec 4 --spec-min-p 0.5 --mtp rt);单并发(parallel=1);--vram-reserve-mib 1024;--pool-workers 13(唯一例外:R9700+Q4_K_XL 用 16);--ple-io direct(见文末更正)。
| 组合 | 显卡 / 引擎目录 | 模型文件(均在 suma91) | 该组合独有开关 |
|---|---|---|---|
| 5070 Ti + IQ3_S | RTX 5070 Ti / CUDA,5070ti-iq3s-vision(纯文本) | ISTA-DASLab Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S(2 分片 + 独立 PLE 分片) | --prefill auto;对话缓存 --conversation-cache-mib 8192 --conversation-cache-slots 4 |
| 5070 Ti + IQ4_XS | RTX 5070 Ti / CUDA,5070ti-iq4xs(纯文本) | Huihui Qwen3.8-Flash-Next-UD-IQ4_XS(3 分片 93.7 GB) | 专家预算 --resident-budget-gib 55 全驻留;--prefill auto(16G 卡别给大块);对话缓存 8GiB |
| 5070 Ti + Q4_K_XL | RTX 5070 Ti / CUDA,5070ti-udq4kxl(纯文本) | Huihui Qwen3.8-Flash-Next-UD-Q4_K_XL(4 分片 111.3 GB) | --resident-budget-gib 71 全驻留;memlock=unlimited(关键,见正文);--prefill auto;对话缓存 8GiB |
| R9700 + IQ3_S | AMD R9700 / HIP(gfx1201),r9700-iq3s-vision(视觉=CPU 编码器 mmproj BF16) | 同 5070 Ti 的 IQ3_S | STRATA_HIP_WMMA=1 + STRATA_GFX12_CHUNK=1(16K 分块)+ STRATA_ADAPT_OVERLAP=1(+_RESIDENT,计算重叠);--prefill auto:32768(专家缓存 auto,约 25G 显存) |
| R9700 + IQ4_XS | AMD R9700 / HIP,r9700-iq4xs(目录无 mmproj,纯文本) | 同上 UD-IQ4_XS | WMMA + 16K 分块 + 计算重叠;--prefill auto:32768;--resident-budget-gib 55 |
| R9700 + Q4_K_XL | AMD R9700 / HIP,r9700-udq4kxl(视觉=CPU 编码器) | 同上 UD-Q4_K_XL | WMMA + 16K 分块 + 计算重叠;--prefill auto:32768;--resident-budget-gib 71;--pool-workers 16;官方校准 --pcie-frac 0.00 已移除 |